

Що таке Tokenmaxxing? Метрика штучного інтелекту, яка сама себе зламала
 Навчання ChatGPT
 Час читання: 15 хвилин
За 30 днів співробітники Meta проштовхнули приблизно 60 трильйонів токенів штучного інтелекту через внутрішню таблицю лідерів, яка ранжувала їх за споживанням.
Ми розглядаємо законопроект, який правдоподібно вивільнив 100 мільйонів доларів на створення роботи, яка була значною мірою продуктивною. Через 90 днів таблиця лідерів зникла, і компанія суворо нормувала штучний інтелект. Ця дуга називається tokenmaxxing: це коли максимізація використання токенів ШІ перетворюється на показник ефективності та показник продуктивності.
Відтоді компанії порозумнішали, а деякі з них вдалися до надмірної корекції, що стало явищем під назвою «токенмінінг»: використання якомога меншої кількості токенів штучного інтелекту для зменшення обчислювальних витрат. Обидва підходи не вдаються, оскільки вони розглядають кількість токенів як надійний показник зростання, зумовленого штучним інтелектом.
У цій статті ми розглянемо, скільки насправді коштує tokenmaxxing, як інженери його обдурили та яка система вимірювань витримує людей, які добре вміють підраховувати цифри.
Що таке Tokenmaxxing?
Токеномаксизація — це практика максимізації споживання токенів штучним інтелектом та трактування вищого використання як свідчення більшої продуктивності або впровадження ШІ . Токени — це одиниці, які модель ШІ обробляє як вхідні дані та виробляє як вихідні.
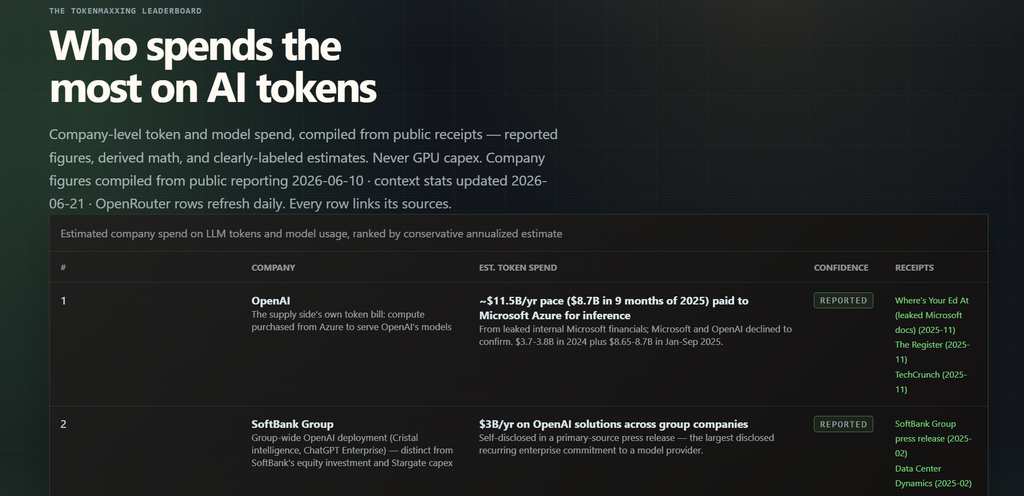
Використання токенів стало привабливим показником продуктивності, оскільки воно видиме, кількісно вимірюване та вже відстежується багатьма платформами штучного інтелекту. Це спрощує звітність про нього, ніж про такі результати, як зекономлений час, покращені рішення або отриманий дохід. Але токени вимірюють обчислювальну активність, а не корисну роботу. Повторювані підказки, невдалі цикли агентів та безглузді результати – все це збільшує число, нічого не виробляючи.
Агенти ШІ погіршують ситуацію. Агент зчитує контекст, викликає інструменти, переглядає власну роботу та передає завдання іншим агентам. Кожен крок спалює токени. Хоча більша активність може означати більше корисної роботи, вона також може означати неефективні робочі процеси та зростання витрат.
Простіше кажучи, головний недолік tokenmaxxing полягає в тому, що команди максимізують видиму кількість, тоді як продуктивність, якість та рентабельність інвестицій залишаються незмінними.
Читайте також: Як бізнесу впровадити генеративний ШІ у 2026 році: практичні стратегії та кейси
Чому Tokenmaxxing став популярним?
Tokenmaxxing став популярним, оскільки керівництву потрібні були цифри, щоб довести, що впровадження штучного інтелекту в компаніях відбувається. А використання токенів було єдиним показником, що відображався в консолі виставлення рахунків.
Генеральний директор Nvidia Дженсен Хуанг задав тон на початку 2026 року в подкасті All-In за допомогою уявного експерименту про токен-рахунок високооплачуваного інженера.
«Якби цей інженер вартістю 500 000 доларів не витратив токенів на суму щонайменше 250 000 доларів, я був би дуже стривожений», – сказав він. А якби відповідь була на рівні 5000 доларів? Він би збожеволів.
Використання штучного інтелекту стало видимим маркером того, хто встигає за змінами. Це відбувалося в той час, коли питання про те, які ролі виконуватиме ШІ, виникали на кожній нараді з планування. Інженери, які витрачали токени, виглядали так, ніби адаптувалися до нової парадигми, тоді як ті, хто цього не робив, ризикували виглядати проблемою.
Ось у чому іронія: перша таблиця лідерів токенів ніколи не задумувалася як змагання. Shopify створила її, щоб зрозуміти, чому її найкращі споживачі витрачають так багато, а не для того, щоб порівнювати їх один з одним. Віце-президент і керівник інженерного відділу Фархан Тавар пізніше розповів, як розвивався інструмент.
Компанія перейменувала її на «панель керування використанням», додала автоматичні вимикачі та сповіщення про витрати, а також використовувала дані для виявлення недобросовісних агентів та помилок інфраструктури. Фархан написав:
Tokenmaxxing – це гостра тема. Більше – не означає краще.Ми створили першу таблицю лідерів токенів штучного інтелекту. Потім ми еволюціонували наше мислення.Вона стала панеллю використання. Ті самі дані, але з іншою структурою. Ми додали автоматичні вимикачі та піки витрат. Спіймали агентів-втікачів. Знайшли помилки у власній інфраструктурі.Справжній сигнал: не хто витратив найбільше, а ті, чиї токени мали найбільший вплив. Це ті інженери, з якими я хочу поговорити.
Більшість компаній, які скопіювали рейтингову таблицю Shopify, використовували її для ранжування співробітників замість того, щоб досліджувати витрати на штучний інтелект. У таблиці нижче показано, як це відбувалося в кожній з них.
| Компанія | Механізм | Що сталося далі |
|---|---|---|
| Shopify | Перша відома таблиця лідерів токенів, яка використовується для дослідження тих, хто багато витрачає | Перейменовано на «панель керування використанням» з доданими автоматичними вимикачами для вилову агентів-втікачів |
| Мета | «Кладеономіка» – рейтингова таблиця лідерів, створена співробітниками, яка охоплює 250 найкращих із понад 85 000 співробітників, з такими назвами, як «Легенда токена» | 60,2 трильйона токенів за 30 днів; видалено протягом кількох днів після висвітлення у пресі |
| Амазонка | Kirorank — неофіційна таблиця лідерів, яка оцінює розробників за активністю Kiro AI, а як призи — значки PhoneTool. | Працівники дають агентам тривіальні та вигадані завдання, а таблицю лідерів скасували. |
| Убер | Немає рейтингової таблиці; Claude Code розгорнуто приблизно для 5000 інженерів | Річний бюджет на штучний інтелект вичерпано за чотири місяці, після чого щомісяця встановлено обмеження у 1500 доларів на кожен інструмент |
| Волмарт | Code Puppy, власний агент зі штучним інтелектом з початково необмеженою кількістю токенів | Фіксована норма токенів на одного співробітника після дублювання запитів, що призвели до збільшення витрат |
Закономірність у цій таблиці є послідовною. Організації, які використовували дані токенів для дослідження високих витрат, зберегли робочий сигнал. Інші, які використовували їх для ранжування людей, втратили цей сигнал протягом кварталу.
Як інженери завищили використання токенів?
Інженери завищували використання токенів, генеруючи дорогу активність штучного інтелекту, яку вони ніколи не планували запускати. The Pragmatic Engineer повідомив про таку поведінку в Meta, Microsoft та Salesforce та виявив чотири поширені тактики. Жодна з них не мала поганого наміру. Люди просто бачили видиму цифру, хвилювалися через звільнення та вважали, що інтенсивне використання штучного інтелекту захистить їх:
- Задаючи агенту зайві питання: Інженери запитували у ШІ код, який вже був задокументований. Модель перечитувала документацію та повертала повторювані й неправильні відповіді, споживаючи при цьому велику кількість токенів.
- Створення одноразових прототипів: вони створили функції, які ніколи не хотіли використовувати, ініціювали кілька додаткових раундів, а потім видалили гілку.
- Використання агента для всього: Вони передали ШІ завдання, які той міг швидше виконати вручну, лише для того, щоб збільшити його використання.
- Запуск паралельних агентів: Вони налаштували кількох агентів для перегляду та обговорення роботи один одного, що призвело до довгих журналів, але не до робочого програмного забезпечення.
Багато інженерів перевіряли витрати своїх колег. Потім вони споживали рівно стільки, щоб трохи перевищити середній показник. Вони не хотіли бути позначеними не лише як лідери, але й як неоцінені критики за недостатнє використання штучного інтелекту.
В Amazon співробітники призначали агентам зі штучним інтелектом тривіальні та вигадані завдання, щоб підвищити їхні бали Kirorank. Це збільшувало витрати на хмарні технології , не приносячи жодних бізнес-результатів. Коли Amazon припинив використовувати таблицю лідерів, старший віце-президент Дейв Тредвелл сказав співробітникам, що вона була створена з добрими намірами. Потім він прямо попросив: «Будь ласка, не використовуйте штучний інтелект лише заради використання штучного інтелекту».
У рамках цих змін Amazon тепер відстежує, чи працює код, згенерований штучним інтелектом, і чи приносить він цінність. Споживання токенів не є його головним пріоритетом.
Скільки коштував компаніям Tokenmaxxing?
Tokenmaxxing, ймовірно, коштував Meta понад 100 мільйонів доларів за один місяць і виснажив річний бюджет Uber на штучний інтелект за чотири місяці. Оцінка Meta базується на простих арифметичних розрахунках.
За цінами API, встановленими Claude Opus (на момент публікації новини), 60,2 трильйона токенів коштували б приблизно 900 мільйонів доларів . Компанія розміру Meta домовляється про значні знижки, але навіть тоді рахунок може сягати дев’ятизначної суми.
Uber пропонує найчіткіше уявлення про витрати, оскільки ніколи не проводив рейтинг лідерів. Компанія надала приблизно 5000 інженерам інструменти агентського кодування без моделі витрат. Протягом місяця частка інженерів, класифікованих як агентські користувачі, зросла з 32% до 84% . Весь річний бюджет був вичерпаний за чотири місяці.
Технічний директор Правін Неппаллі Нага визнав, що компанія «повернулася до початкового стану» зі своїми припущеннями. Щомісячні рахунки коливалися від 500 до 2000 доларів на інженера, і рішення було очевидним: щомісячне обмеження в 1500 доларів на інструмент кодування на інженера.
Коли інженери, які виконують порівнянну роботу, витрачають таку різну суму, ця різниця показує, що ніхто не визначив, як виглядає належне використання. Тож кожен інженер винайшов своє власне визначення. Виконавчий директор Uber Ендрю Макдональд визнав це, заявивши Fortune , що «дуже важко провести межу» між кодом, створеним за допомогою штучного інтелекту, та корисними функціями, які фактично постачаються.
Звіт LeadDev про вплив штучного інтелекту показав, що лише 19% керівників-інженерів оцінюють tokenmaxxing як ефективний. 57% з них кажуть, що він не вимірює реальної цінності.
Ось чому гроші обертаються так швидко: агент, який планує зміну коду, читає репозиторій, викликає інструменти, запускає тести та повторює спроби, доки не досягне успіху. Один цикл може спожити десятки тисяч токенів, а кеш запитів зчитує дані, які мають ще більшу кількість.
Урок: Фінансові команди планували бюджет на ШІ так, ніби це ліцензія на робоче місце. Але насправді це поводиться як хмарні обчислення. Така ж бухгалтерська прогалина виникає, коли команди збирають стек ШІ від кількох постачальників, не передаючи нікому права власності на рахунок. Це той самий режим невдачі, що й некероване розповсюдження інструментів , але на один рівень вище.
Що таке токенмінінг?
Токемінінг — це практика мінімізації споживання токенів штучним інтелектом та ставлення до низького рівня використання як мети. Як ми обговорювали у вступі, це надмірна корекція, яка має аналогічно погані результати. Назва є скороченням від «мінімізація токенів» і виникла як корекція tokenmaxxing. Газета « Нью-Йорк Таймс» повідомила про цю зміну в кількох компаніях.
Meta повідомила співробітникам, що обмежить використання штучного інтелекту після «експоненціального зростання» витрат. Uber обмежила щомісячні витрати, Walmart встановила ліміти на інструменти, а Amazon та Meta понизили свої рейтинги. Протягом кількох тижнів ті ж компанії, які відзначали своїх найактивніших користувачів ШІ, навчили всіх нормувати споживання.
Це виправлення повторює помилку, яку мало виправити. Закон Гудхарта пояснює це найкраще: коли показник стає ціллю, він перестає бути хорошим показником. Тож, якщо ви встановите використання токенів ШІ як мету, люди знайдуть способи оптимізації для цього показника, навіть ціною підриву початкового наміру. Закон Гудхарта застерігає від tokenmaxxing та tokenminning.
Якщо винагородити команду за спалювання токенів, вона спалюватиме непотрібні токени . Якщо винагородити команду за збереження токенів, вона пропустить прогін ШІ, який міг би виявити помилку. Або ж вона розділить один ретельний сеанс на три дешеві, кожен з яких поверне поверхневу відповідь. Обидві команди досягають своїх цілей використання токенів, тоді як фактична робота погіршується.
Сам контроль витрат не є помилкою. Як і у прикладі з Uber, щомісячне обмеження в 1500 доларів США є бюджетним рішенням після того, як компанія витратила річний бюджет за чотири місяці. Але встановлення ліміту витрат вирішує лише фінансову проблему. Воно не відповідає на питання, чи купили токени щось корисне.
Вихід полягає в тому, щоб розділити два типи чисел: сигнали, які ви спостерігаєте, та результати, до яких ви прагнете. Використання токенів, коефіцієнт впровадження та частка коду, написаного штучним інтелектом, – це сигнали, які показують, що відбувається всередині системи. Вони корисні, коли ви досліджуєте проблему, але вони погано впливають на цілі. Тому що кожен з них може сильно змінитися, і клієнт не помітить жодної різниці.
Організація повинна прагнути результатів. Вони дотримуються тієї ж логіки, що й будь-який добре побудований набір ключових показників ефективності розробки програмного забезпечення : пов’язують ранній сигнал із результатом, який він має передбачити. Конвертація панелі інструментів Shopify є шаблоном: ті самі дані, ніхто з лідерів не прив’язаний до них.
Ніл Дхар , старший віце-президент IBM Consulting, описав, як поширюється плутанина, у своєму есе про вартість штучного інтелекту.
#Tokenmaxxing останнім часом постійно обговорюється. Організації прагнуть використовувати якомога більше штучного інтелекту і якомога швидше, перетворюючи використання на показник цінності. Тепер настає термін оплати. Оскільки витрати на штучний інтелект випереджають прибутковість, інстинкт спонукає до скорочення витрат. Але одне лише скорочення витрат не вирішить основну проблему рентабельності інвестицій.
Згідно з IBM , виправлення полягає в тому, щоб розглядати використання як сигнал і поєднувати його з результатом, який неможливо підробити.
Чи означає більше використання токенів вищу продуктивність?
Ні, високий рівень використання токенів не означає високу продуктивність. Найбільші доступні набори даних показують, що ці два фактори розвиваються незалежно. Дослідження платформи аналітики розробників DX показало, що впровадження штучного інтелекту близьке до насичення , тоді як виміряне зростання продуктивності залишилося незмінним.
Технічний директор DX Лаура Тачо поділилася цифрами. Серед розробників 92,6% зараз користуються послугами асистента зі штучного інтелекту принаймні щомісяця, а приблизно 75% — щотижня. Штучний інтелект пише 26,9% коду в реальному часі. Проте, за словами самих розробників, економія часу залишається приблизно 4 годинами на тиждень вже понад рік. А початкове 10% зростання продуктивності так і не зросло.
Використання продовжувало зростати, тоді як результати залишалися незмінними. Будь-який показник, який відстежує лише використання, повідомляв про перемогу, якої ніколи не було.
Звіт DORA від Google Cloud пояснює, чому одні й ті ж інструменти дають такі різні результати. У ньому було виявлено, що впровадження штучного інтелекту покращило швидкість доставки, але погіршило її стабільність . У звіті штучний інтелект описується як підсилювач: він посилює сильні сторони добре керованих організацій та слабкі сторони тих, що зазнають труднощів.
Власні дані DX показують, що цей підсилювач працює. В одній групі з 67 000 розробників деякі організації подвоїли кількість інцидентів, пов’язаних з клієнтами, тоді як інші скоротили їх вдвічі , використовуючи ті самі інструменти протягом того ж періоду. Tacho покладає відповідальність на те, на що вказують дані:
Це справді проблема управління. Ця галасуна створювала враження, що сама спроба використання штучного інтелекту автоматично окупиться. Але досі більшість інструментів використовувалися для окремих завдань кодування. Щоб побачити реальний ефект, нам потрібно використовувати штучний інтелект на організаційному рівні, а не лише для окремих завдань.
Під першою проблемою криється ще одна: люди неправильно оцінюють власне прискорення роботи ШІ. Некомерційна дослідницька лабораторія METR провела рандомізоване контрольоване дослідження. 16 досвідчених розробників з відкритим кодом виконали 246 реальних задач у репозиторіях, які вони підтримували в середньому протягом п’яти років. Перед початком розробники передбачали, що ШІ зробить їх на 24% швидшими. Після завершення вони оцінили, що він зробив їх приблизно на 20% швидшими. Секундомір показав, що вони стали на 19% повільнішими.
У подальшому оновленні лабораторія пояснила, що її наступний експеримент зіткнувся з ефектами відбору, які вона не змогла виправити. Вона також заявила, що розробники, ймовірно, тепер справді швидші за допомогою штучного інтелекту, значною мірою завдяки агентним інструментам. Що виживає: самозвітна продуктивність не замінює виміряну продуктивність, і розрив між ними може бути в будь-якому напрямку.
Що слід вимірювати замість використання токенів?
Замість використання токенів, вимірювайте результати на рівні команди, а потім на рівні організації. Ставтеся до використання токенів як до сигналу вартості, за яким ніхто не ранжується. Важливими є отримані результати.
Одне практичне правило, якого варто дотримуватися: поєднуйте кожен публікований сигнал з результатом, який він не може завищити. Команда може спалювати токени, нічого не відправляючи. Однак вона не може імітувати падіння рівня невдалих змін.
| Метрика | Тип | Як ним користуватися |
|---|---|---|
| Токени, використані командою | Сигнал | Слідкуйте за різкими стрибками витрат та неконтрольованими циклами агентів; ніколи не ранжуйте окремих осіб за цим показником |
| Рівень впровадження інструментів штучного інтелекту | Сигнал | Переконайтеся, що оновлення охопило людей, а потім перестаньте його переглядати. |
| Відсоток коду, створеного штучним інтелектом | Сигнал | Контекст для планування можливостей перевірки коду |
| Зміна коефіцієнта відмов | Результат | Поєднайте це з будь-яким заявленим приростом швидкості; проблеми з’являються тут першими |
| Об’єднання запитів на зняття (pull requests) для кожної команди | Результат | Тільки на рівні команди, завжди збалансовано з показником якості |
| Оцінка досвіду розробника | Результат | Виявляє шкоду культурі, перш ніж люди почнуть йти |
| Відсоток часу, витраченого на нові можливості | Результат | Поєднує інженерні зусилля з бізнес-цінністю |
Ця структура походить від систем вимірювання, яким вже довіряють лідери інженерії. DORA охоплює швидкість доставки та стабільність, і її висновок про те, що штучний інтелект посилює обидва ці фактори, є причиною важливості цього поєднання.
DX Core 4 вимірює чотири виміри : швидкість, ефективність, якість та вплив на бізнес. Абі Нода та Лаура Тачо створили його разом із Ніколь Форсгрен та Маргарет-Енн Сторі, дослідницями DORA, SPACE та DevEx. Ці чотири виміри навмисно взаємодіють.
Команда, яка покращує один фреймворк за рахунок іншого, одразу виявляє компроміс. Жоден фреймворк не містить метрики токена, і жоден з них її не додав.
Три правила забезпечують дотримання парної схеми на практиці:
- Завжди агрегуйте на рівні команди. Коли сигнал пов’язаний з іменем окремої особи, він стає ціллю, і ера таблиць лідерів повертається протягом спринту. Команди можуть враховувати відмінності у використанні ШІ учасниками. Окремі особи керуватимуть кількістю.
- Ніколи не показуйте сигнал без парного результату в одному поданні. Панель інструментів, яка відображає лише витрати токенів, сприяє оптимізації. Витрати токенів поруч із коефіцієнтом невдалих змін спонукають до кращого питання: чи працюють витрати?
- Уникайте сигналів у оцінках ефективності . Коли показник використання стосується компенсації або підвищення, спрацьовує закон Гудхарта, незалежно від того, в якому напрямку вказує стимул. Використовуйте дані про використання для розслідування, а не для оцінки індивідуальних заслуг.
Як встановити політику використання штучного інтелекту, якою співробітники не маніпулюватимуть?
Щоб встановити політику використання штучного інтелекту, яку співробітники не зможуть маніпулювати, видаліть усі видимі цифри зі статусу особи та прийміть п’ять рішень:
1. Визначтеся з призначенням номера, перш ніж збирати його
Кожна метрика в політиці потребує письмового призначення перед випуском першої панелі інструментів. Таблиця лідерів Shopify працювала у своєму першому житті. Керівництво використовувало її, щоб розпочати розмови з тими, хто витрачає багато коштів, про те, що вони створювали. Номер розпочав розслідування. Щойно той самий номер завершив розслідування, зробивши висновок про людину, а не запитаючи щось про роботу, це перетворюється на бал. А балами керують.
Запишіть три речі для кожного показника:
- Тригер: Яка зміна у витратах токенів спонукає до дії (стрибок у 3 рази порівняно з тижнем або подвоєння командою базового рівня)
- Дія: Хто що запитує і кого («менеджер з інформаційних технологій запитує команду, що вони будують», а не «звіт надсилається віце-президенту»)
- Бездіяльність: Для чого номер ніколи не буде використано, зазначено так само чітко
Лінія бездіяльності має найбільше значення, оскільки співробітники перевіряють політику на її основі. Якщо чесна відповідь на питання «що відбувається, коли витрати зростають» стосується чийогось статусу, ви створили таблицю лідерів із додатковими кроками.
2. Встановіть бюджет на рівні команди
Спільний бюджет команди замінює обмеження на одну людину, і різниця полягає в поведінці, а не в бухгалтерському обліку. Розподіл Uber від 500 до 2000 доларів США щомісяця між інженерами, які виконують порівнянну роботу, показує, що відбувається без спільної точки відліку. Кожен винаходить своє власне визначення розумного. Бюджетні конверти працюють так само, як і будь-які інші зусилля щодо об’єднання розпорошених витрат на ШІ в одному підзвітному місці.
Конверт дає вам три речі, яких не може купити ліміт на людину:
- Еластичність: справді дорога міграція може спожити більше цього місяця, тоді як звичайний спринт споживає менше
- Психологічна безпека: Ніхто не сприймає власний рядок позиції як оцінку ефективності, оскільки в ньому немає рядка з його іменем.
- Самоконтроль: Неконтрольовані витрати виявляє сама команда, оскільки конверт є спільним і видимим для всіх його учасників
Розмір першого конверта визначте на основі спостережуваних даних. Візьміть середнє значення команди за останні три місяці та додайте запас для одного дорогого проекту. Конверт, встановлений на основі здогадок, буде порушено на другому тижні, навчаючи всіх, що політика є декоративною.
3. Зробіть дорогий шлях видимим
Покажіть інженерам вартість кожного запуску, замість того, щоб обмежувати їхні витрати. Запуски агентів, які зациклюються на невдалих тестах, – це те, де зникають бюджети, висуваючи жорстке обмеження на перший план. Інший варіант – висвітлити вартість за запуск інженеру, який його ініціював, без звітування про це вище.
Інженер, який спостерігає, як цикл повторних спроб витрачає 40 доларів, виправить цикл. З іншого боку, інженер, який боїться звіту, повністю припинить використовувати агента, включаючи ті випадки, коли дорогий запуск був правильним рішенням.
Автоматичні вимикачі Shopify працюють таким чином: система виявляє аномалію, і людина, яка знаходиться найближче до роботи, вирішує, що робити. Видимість змінює поведінку швидше, ніж обмеження, і вона зберігає доступність дорогого, але правильного виконання, коли робота виправдовує витрати.
4. Відокремте мету впровадження ШІ від оцінки ефективності
Зафіксуйте розрив у письмовій формі, оскільки усні запевнення не переживають циклу звільнень. Інженер Microsoft, який описав завищення власних показників використання в «Прагматичному інженері», не гнався за призом. Вони уникали ярлика за рік звільнень, спричинених штучним інтелектом.
Якщо люди вірять, що дані про використання потрапляють на нараду з калібрування, вони керуватимуть цими даними, що б хто не говорив вголос.
Для формулювання політики потрібно рівно два рядки:
- Чи можуть дані про використання відображатися в розмовах про продуктивність (так чи ні, не «залежно від контексту»)
- Куди дані потрапляють, щоб ніхто не заповнював тишу гіршими припущеннями
Тоді поважайте обидва. Перший інженер, який побачить дані про використання в огляді, розповість про це всім, довівши зайвість метрики.
5. Переглядайте пари щокварталу
Щокварталу запитуйте, чи кожна діагностика все ще пояснює результат, з яким вона пов’язана. Ціноутворення моделі, поведінка кешування та архітектура агента змінюються швидше, ніж річний цикл планування.
Те, як команди застосовують штучний інтелект для планування та звітності, постійно змінюється. Кількість токенів, яка означала одне в січні, означає щось інше в червні, після двох знижок цін та підвищення рівня агента.
Огляд містить чесні результати для кожної метрики: вона все ще передбачає парний результат, потребує перекалібрування відповідно до нових цін, або перестала щось пояснювати та була виведена з експлуатації без церемоній. Команди найбільше опираються виведенню з експлуатації. Однак, це важливий показник, тому що метрика, яка переживає своє значення, є саме тим числом, на якому була побудована ера таблиць лідерів.
Типові помилки команд під час вимірювання впровадження ШІ
Чотири найпоширеніші помилки — це ставлення до впровадження як до фінішної прямої, довіра до самостійно заявленої економії часу, публікація окремих таблиць лідерів та вимірювання швидкості без вимірювання стабільності. Ви можете виявити кожну з них, перш ніж це стане дорогим.
1. Ставлення до усиновлення як до фінішної прямої
Панель розгортання показує 90%, керівництво оголошує ініціативу зі штучного інтелекту завершеною, і ніхто не питає, що змінилося далі. Дані DX викрили цю пастку в масштабі: 92,6% впровадження при незмінній продуктивності на рівні 10%. Впровадження лише підтверджує, що інструменти досягли людей. Воно нічого не говорить про те, що змінили ці інструменти.
Виправлення: Вилучити діаграму впровадження після завершення розгортання та замінити її сполученням сигнал-результат.
2. Довіра до самостійно повідомленої економії часу
Згідно з опитуванням, команда заощаджує п’ять годин на тиждень, але час циклу не змінився протягом двох кварталів. Дослідження METR показує, чому ці дві цифри розходяться: розробники, які працювали помітно повільніше зі штучним інтелектом, все одно оцінювали прискорення на 20% після цього. Те, у що вірять люди, і те, що фіксує годинник, — це два різні виміри.
Виправлення: Залиште опитування для розробників, де сприйняття має значення. Використовуйте системні дані для будь-яких заяв щодо часу.
3. Публікація індивідуальної таблиці лідерів просто заради розваги
Хтось створює його на внутрішній вікі за день, дає йому жартівливі назви, і команда щиро насолоджується ним протягом приблизно трьох тижнів. Потім стимул бере гору. Claudeonomics від Meta та Kirorank від Amazon починалися як розвага для масового споживача. Обидві компанії закрили їх, коли ігровий ентузіазм переріс ентузіазм.
Виправлення: агрегуйте дані на рівні команди або не надсилайте їх.
4. Вимірювання швидкості без вимірювання стабільності
Пропускна здатність зростає, всі святкують, а кількість інцидентів зростає на інформаційній панелі іншої команди. Звіт DORA визначив саме цей розподіл: швидкість покращується, тоді як стабільність погіршується. Зберігання двох показників на окремих інформаційних панелях дозволяє проблему приховати.
Виправлення: Розмістити показник частоти збоїв змін на тому ж екрані, що й будь-який показник швидкості, а не в окремому огляді надійності, на який ніхто не посилається.
Хто найбільше використовує штучний інтелект
Вся історія зводиться до одного правила: використовуйте дані токенів, щоб ставити запитання, а не оцінювати людей. Shopify запитав: «Що створюють наші найбільші витрачальники?» і знайшов агентів-невдах та помилки в інфраструктурі. Meta та Amazon запитали: «Хто найбільше використовує штучний інтелект?» і отримали фальшиві завдання, витрачені мільйони та мертві таблиці лідерів.
Тож зробіть три речі цього кварталу. Перенесіть відстеження токенів на рівень команди та видаліть усе, що містить ім’я окремої особи. Запишіть у політиці, що дані про використання ніколи не стосуються оцінки ефективності. І розмістіть один показник якості (найпростіше – це рівень невдалих змін) на тому ж екрані, що й кожен показник швидкості, про який ви повідомляєте.
Настав час, щоб люди всюди використовували сучасні потужні технології, які допомагають оптимізувати повсякденні задачі. Це дає можливість зекономити час і зосередитися на важливих аспектах життя, дозволяючи більше уваги приділяти хорошим речам, які справді важливі.
Для тих, хто прагне глибше освоїти технології штучного інтелекту та інтегрувати їх у власне життя і бізнес, Академія CGPT пропонує широкий вибір навчальних програм і курсів. Вони допоможуть не лише опанувати інструменти, як-от ChatGPT, а й розкрити потенціал штучного інтелекту для максимального покращення продуктивності та розвитку.
Розпочніть свій шлях до продуктивності вже сьогодні разом з Академією CGPT!
Приєднуйтесь до навчальних програм від AcademyCGPT.
Щоб отримати докладні статті про штучний інтелект, відвідайте наш блог, який ми створюємо з любов’ю до технологій, людей та їхніх потреб.
17.09.2026 Владислав Зінов'єв


